La guía definitiva de Claude Code para desarrollo: carpetas, skills y flujos
Cómo se usa Claude Code de verdad para programar: el loop de trabajo, la arquitectura de carpetas que decide si te acelera o te frena, y qué skills conviene montar. Y lo que dice la evidencia —SWE-bench, el estudio de METR— cuando dejas el marketing de lado. Con todo citado a la documentación de Anthropic y a los papers.
Casi todo lo que se escribe sobre Claude Code es una lista de trucos. Este post no. Es un intento de referencia: cómo se usa de verdad en desarrollo de software, qué arquitectura de carpetas es la canónica, qué skills conviene montar, y —lo más importante— qué dice la evidencia cuando dejamos el marketing de lado. Todo lo que afirmo aquí está citado a documentación oficial de Anthropic o a papers, y lo verás en Fuentes al final.
Empecemos por la única idea de la que cuelga todo lo demás:
El principio: no rinde el agente, rinde el repo que le das
Claude Code no es autocompletado, es un agente: lee, planifica, edita, ejecuta comandos y se corrige. Y un agente rinde según el entorno en el que lo pones. La misma herramienta, en un repo sin estructura, te frena; en un repo diseñado para agentes, te multiplica. Este artículo trata de esa diferencia: la arquitectura. No de prompts mágicos.
¿Suena exagerado que la estructura importe más que el modelo? La evidencia va en esa dirección, y de paso incomoda. En un ensayo controlado de METR (2025), desarrolladores open-source experimentados que podían usar IA tardaron un 19 % más en cerrar sus tareas —aunque ellos creían que iban más rápido—. La herramienta no era mágica por sí sola. Lo que separa el 19 % de más lento del salto de productividad real es el método y el andamiaje del repo. A eso vamos.
1 · Cómo se usa Claude Code: el loop agéntico
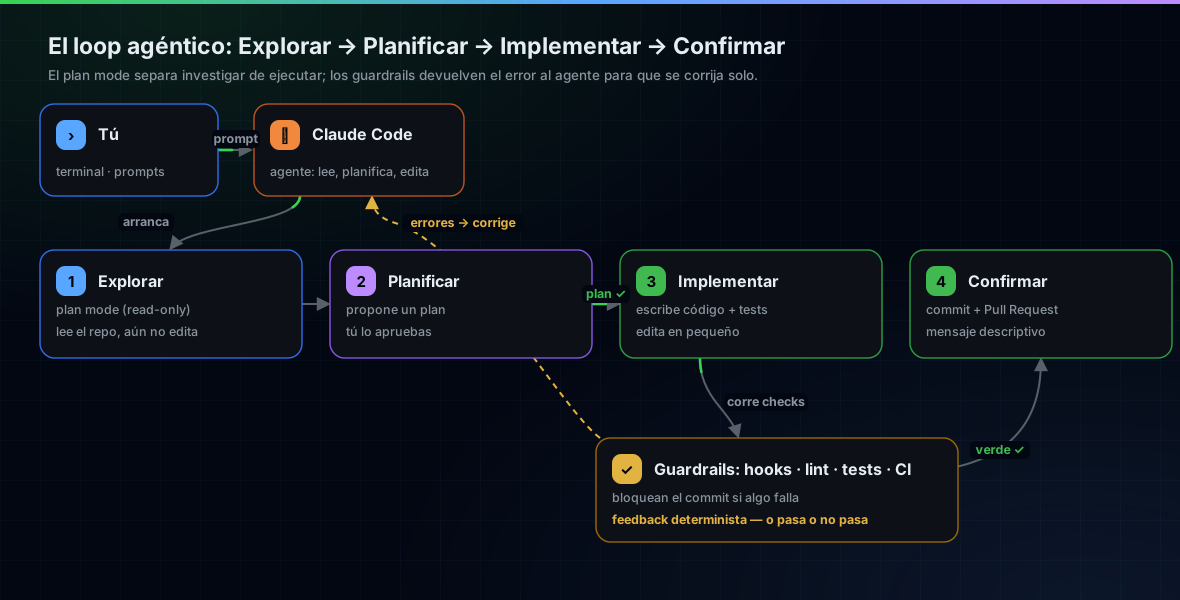
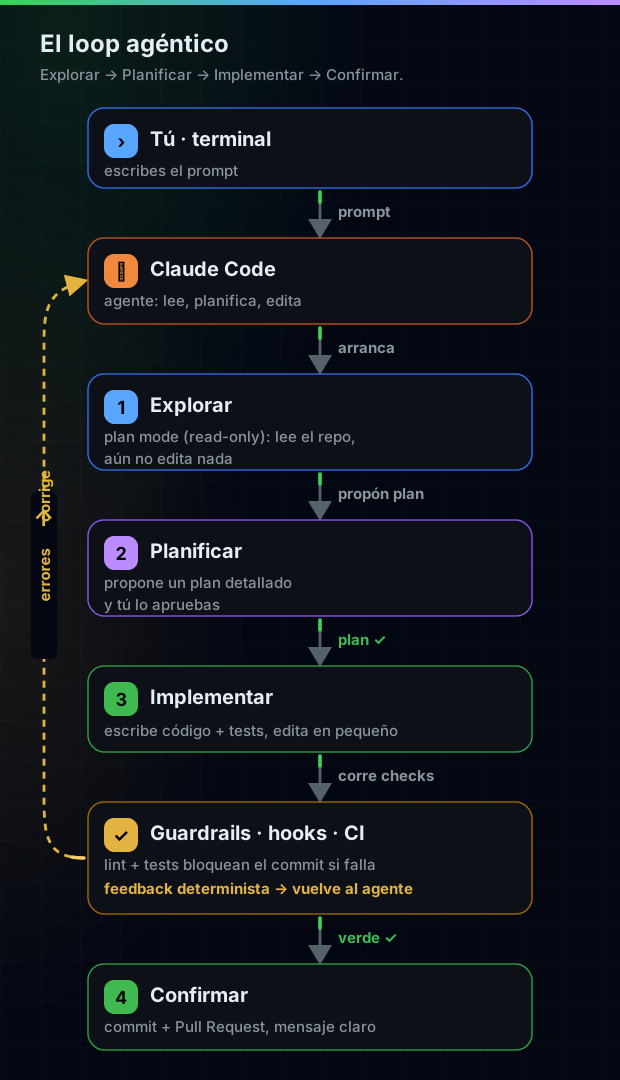
Anthropic documenta un flujo recomendado de cuatro fases: Explorar, Planificar, Implementar y Confirmar. La clave no son las fases en sí, sino la costura entre ellas: el plan mode separa investigar de ejecutar, para que el agente no salte a codificar y termine resolviendo el problema equivocado.
Explorar (plan mode): mira antes de tocar
Entra en plan mode con Shift+Tab (o arranca con claude --permission-mode plan). En este modo Claude solo lee: recorre el repo, entiende las convenciones, localiza los archivos que importan. No edita nada todavía. Es la fase que la gente se salta y luego paga con un cambio que va en la dirección equivocada.
Planificar: que proponga y tú apruebas
Con el contexto ya cargado, Claude propone un plan detallado de implementación. Lo lees, lo ajustas, lo apruebas. Aquí es donde inviertes cinco minutos para ahorrarte una hora: corregir un plan es barato; revertir un refactor equivocado, no.
Implementar: código + tests, en pequeño
Recién ahora edita. Escribe el código y sus tests, en cambios acotados que puedas revisar. Cuanto más pequeño el paso, más fácil es que los guardrails atrapen un error temprano.
Confirmar: commit + PR con mensaje claro
Cuando los checks pasan, cierra con un commit descriptivo y, si corresponde, un Pull Request. El historial queda legible porque el trabajo se hizo en pasos legibles.
Las piezas que hacen que el loop funcione
Separar exploración de ejecución es la mejora de mayor impacto y menor esfuerzo. En palabras de la propia doc: dejar que Claude salte directo a codificar puede producir código que resuelve el problema equivocado. El plan mode es de solo lectura por diseño: te da un plan que aprobar antes de que se toque una línea.
2 · La arquitectura de carpetas estándar
Un repo pensado para agentes tiene una estructura bastante estable, y conocerla de memoria te ahorra pelear con la herramienta.
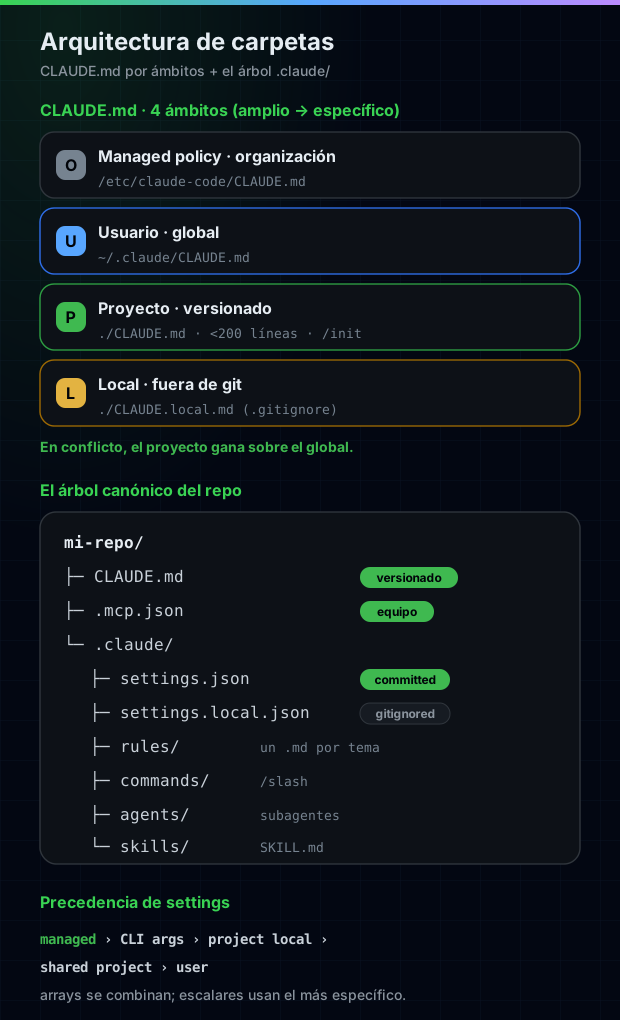
CLAUDE.md: la memoria del proyecto, en cuatro ámbitos
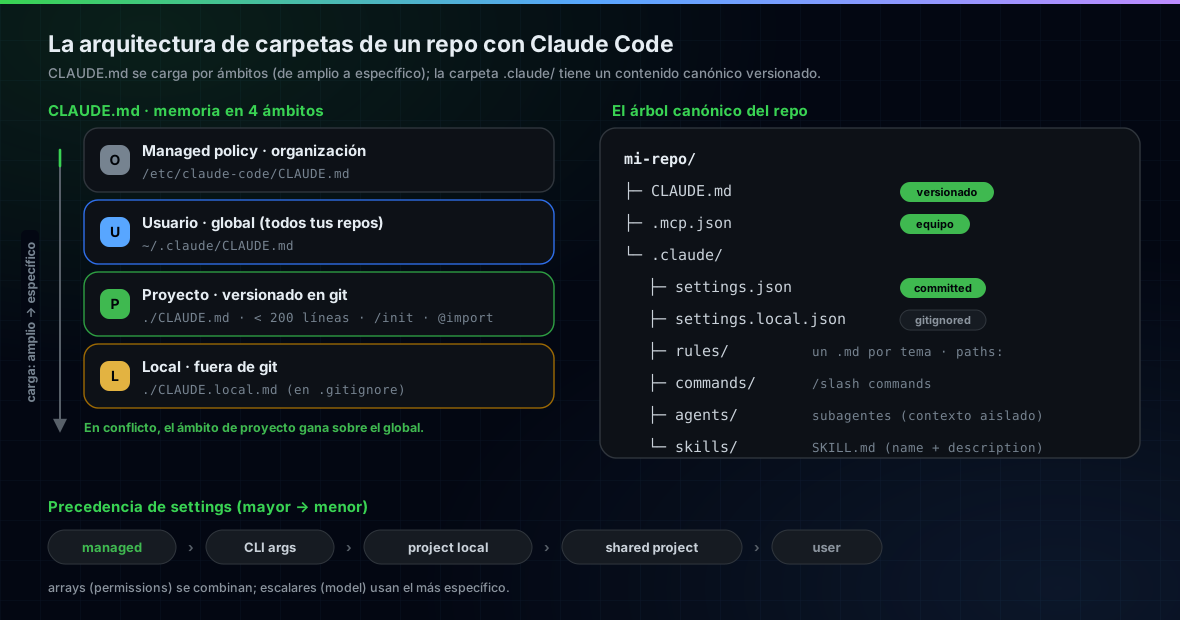
CLAUDE.md es un archivo especial que Claude lee al inicio de cada conversación. Vive en cuatro ámbitos, que se cargan de más amplio a más específico:
- Managed policy (organización) — p. ej.
/etc/claude-code/CLAUDE.md. - Usuario (global, personal) —
~/.claude/CLAUDE.md. - Proyecto (versionado en git) —
./CLAUDE.md(o./.claude/CLAUDE.md). - Local (fuera de git) —
./CLAUDE.local.md.
Los archivos del directorio actual y de cada carpeta superior se concatenan (no se sobrescriben); los de subdirectorios se cargan bajo demanda cuando Claude abre archivos ahí. Cuando hay conflicto, el de proyecto gana sobre el global.
Cortito y al pie
Genéralo con /init, mantenlo por debajo de 200 líneas (más largo se sigue cargando entero, pero se diluye) e importa piezas con @ruta/al/archivo. Escribe reglas operativas, no la historia del proyecto.
La carpeta .claude/: el contenido canónico
Dentro del repo, .claude/ agrupa todo lo que configura al agente:
mi-repo/
├── CLAUDE.md                 # reglas del proyecto (versionado)
├── .mcp.json                 # servidores MCP del equipo (versionado)
└── .claude/
    ├── settings.json         # permisos, hooks, modelo… (committed)
    ├── settings.local.json   # tus overrides (gitignored)
    ├── rules/                # un .md por tema (testing.md, api-design.md)
    ├── commands/             # /slash commands
    ├── agents/               # subagentes
    └── skills/               # SKILL.md por skill
Para proyectos grandes, parte las instrucciones en .claude/rules/ —un tema por archivo— y acótalas por ruta con frontmatter paths:, para que una regla solo se cargue cuando Claude trabaja con archivos que hacen match.
settings.json vs CLAUDE.md: guía vs. ley
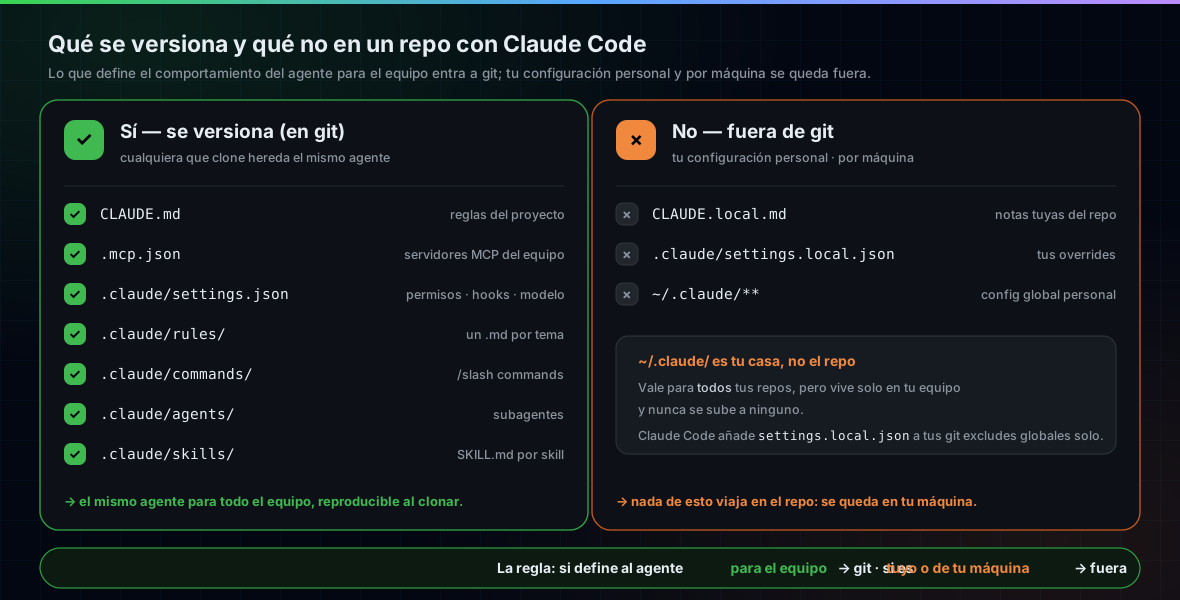
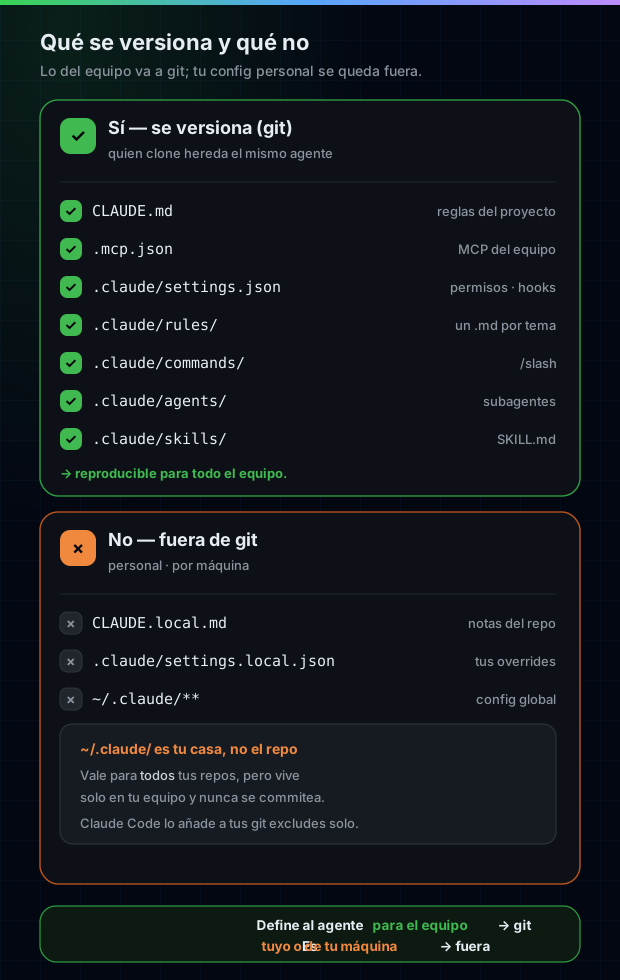
Diferencia que mucha gente confunde: CLAUDE.md es guía (Claude la sigue si la respeta); settings.json es configuración forzada —permisos, hooks, statusLine, model, env— que Claude Code aplica pase lo que pase. Versiona .claude/settings.json para que todo el equipo comparta permisos y hooks; deja settings.local.json para tus overrides (Claude Code lo añade solo a tus git excludes globales la primera vez que lo escribe).
La precedencia, de mayor a menor: managed › CLI args › project local › shared project › user. Los settings de array (como permissions.allow) se combinan entre ámbitos; los escalares (como model) usan el valor más específico.
3 · Los skills adecuados para desarrollo
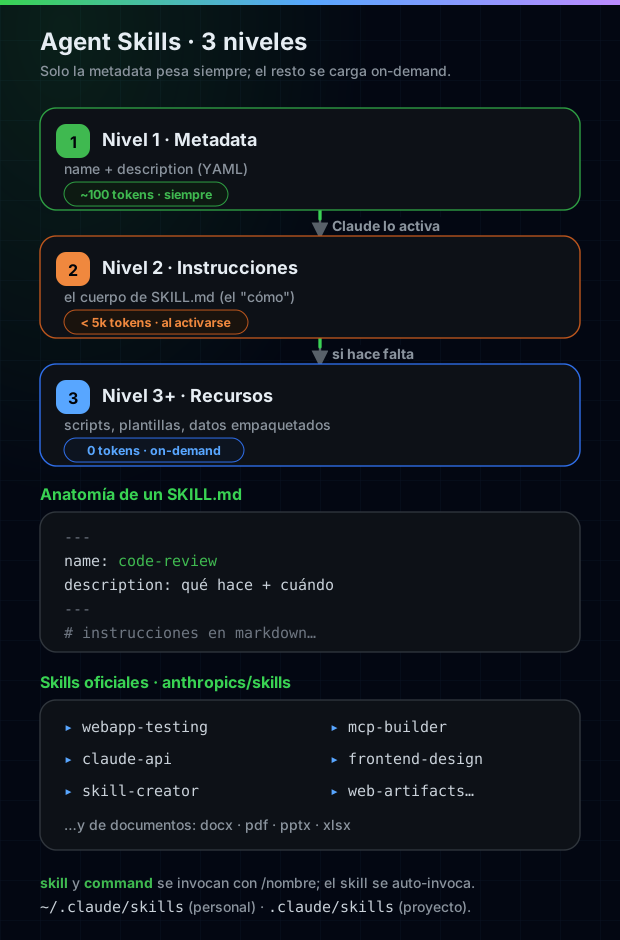
Las Agent Skills son el mecanismo recomendado para empaquetar flujos repetibles. Un skill es una carpeta con un SKILL.md (más los recursos que necesite); un command es un solo .md. Los dos se disparan con /nombre, pero el skill tiene una ventaja: Claude puede invocarlo por su cuenta cuando su description encaja con lo que estás haciendo. Por eso Anthropic empuja los skills para cualquier flujo nuevo que quieras reutilizar.
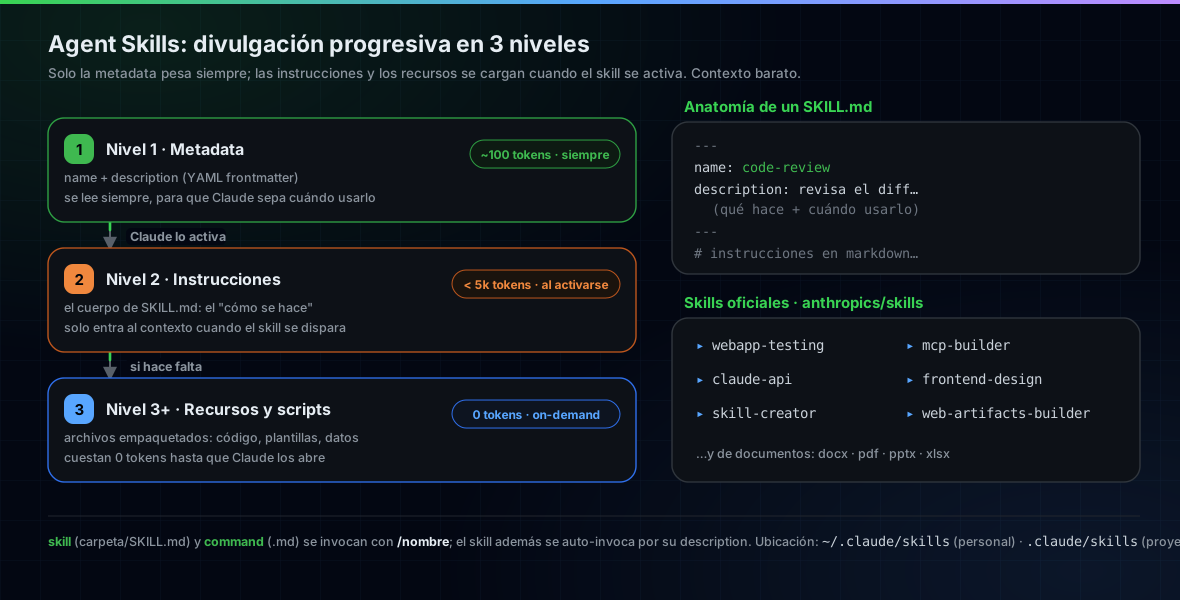
Por qué son baratos: divulgación progresiva
El diseño clave es la divulgación progresiva en tres niveles. Es lo que te deja tener muchos skills sin ahogar el contexto:
- Nivel 1 · Metadata —
name+descriptiondel frontmatter. ~100 tokens por skill, siempre en el system prompt (así Claude sabe cuándo usarlo). - Nivel 2 · Instrucciones — el cuerpo del
SKILL.md. Menos de 5k tokens, cargado solo al activarse el skill. - Nivel 3+ · Recursos — scripts, plantillas, datos empaquetados. 0 tokens hasta que Claude los abre.
Anatomía de un SKILL.md
Los únicos dos campos requeridos del frontmatter son name y description:
---
name: code-review
description: Revisa el diff actual en busca de bugs y problemas de estilo.
  Úsalo cuando el usuario pida revisar cambios antes de commitear.
---

# Instrucciones
1. Corre `git diff` y analiza los archivos cambiados.
2. Señala bugs, code smells y tests faltantes.
3. Devuelve una lista priorizada, sin reescribir el código sin permiso.
Reglas exactas: name máximo 64 caracteres (solo [a-z0-9-], sin las palabras anthropic/claude); description no vacío, máximo 1024 caracteres, y debe decir qué hace y cuándo usarlo. En Claude Code los skills son basados en el sistema de archivos (sin subida por API): ~/.claude/skills/ para uso personal (todos tus repos) o .claude/skills/ para el proyecto (versionado).
Cuáles usar
El repositorio oficial anthropics/skills trae skills técnicos listos: webapp-testing, mcp-builder, claude-api, frontend-design, skill-creator y web-artifacts-builder (además de los de documentos: docx, pdf, pptx, xlsx).
Criterio para elegir (y crear) skills
Convierte en skill lo que hagas repetido y con reglas: tu code-review, tu security-review, tu batería de tests, tu receta de refactor. Empieza por skill-creator para andar el patrón. Y no acumules por acumular: un skill con una description afilada, que se dispara en el momento justo, vale más que veinte que nunca se activan bien.
4 · Lo que dice la evidencia (sin marketing)
Los números existen; el punto es leerlos con honestidad.
SWE-bench es el benchmark de referencia: el paper original (Princeton, arXiv:2310.06770) reúne 2 294 problemas reales de issues + pull requests de 12 repos Python. Su variante SWE-bench Verified (500 casos revisados por humanos, curada por OpenAI) es la que se cita para agentes; sobre ella, Claude 3.5 Sonnet marcó 49 %, superando el estado del arte previo de 45 %. La filosofía de Anthropic para lograrlo fue reveladora: scaffolding mínimo, máximo control al modelo. Ya hay variantes más duras —SWE-bench Pro, con 1 865 problemas de 41 repos profesionales (open-source y privados)— precisamente porque las viejas se saturaron.
Con un matiz que importa. Un trabajo reciente (arXiv:2512.10218) muestra que parte de esos puntajes puede reflejar memorización del set de entrenamiento más que capacidad real. Y otro (arXiv:2510.08996) apunta a un desajuste de formato: los issues largos y formales del benchmark no se parecen a las preguntas cortas que uno escribe de verdad. Un número alto ahí no te promete productividad en tu repo.
El dato incómodo: la IA puede volverte más lento
El ya citado ensayo de METR (RCT, 16 desarrolladores open-source con años de experiencia en sus repos, 246 tareas) encontró que, con IA permitida, tardaron 19 % más —y aun así percibían que habían ido más rápido—. La lección no es "no uses IA": es que la ganancia no es automática. Depende de la tarea, de tu dominio del repo y —vuelta al principio— de la arquitectura y el método con que operas al agente. Una revisión sistemática de 2026 (AI and Ethics, Springer) que cribó 40 412 papers y analizó 44 estudios primarios va en la misma línea: los resultados de productividad y seguridad son heterogéneos, no un cheque en blanco.
Qué NO hacer
Los anti-patrones que rompen el loop
- Un
CLAUDE.mdgigante. 300 líneas se diluyen. Menos de 200, con reglas operativas, se respetan. - Torre de MCPs "por si acaso". Cada servidor cobra peaje de contexto antes de tu primer mensaje. Uno bueno y enfocado gana.
- Saltarte el plan mode en cambios grandes. Es la forma más barata de no resolver el problema equivocado.
- Dar secretos al contexto. El
.envno entra; si falta una variable, que el agente pregunte. - Creerte los benchmarks. 49 % en SWE-bench no es tu productividad. Mide en tu repo, con tus tests.
- Esperar magia sin andamiaje. Sin hooks, sin tests, sin guardrails, el agente no tiene con qué corregirse. Ahí es donde aparece el 19 % de más lento.
Cierre
Si te llevas una sola cosa, que sea el principio del inicio: el repo es el que rinde, no el agente. La arquitectura de carpetas (CLAUDE.md por ámbitos, .claude/ canónico, settings versionados), el loop de cuatro fases con plan mode, los subagentes para revisión adversarial, los MCP justos y los hooks como guardrail no son "configuración": son lo que convierte a un modelo capaz en un colaborador que se corrige solo. La evidencia lo confirma por la vía dura —sin ese andamiaje, la IA hasta te frena—.
¿Cómo se ve esto en un stack real?
Estoy preparando dos casos concretos, uno por capa, que aplican todo esto a un repo de verdad: Claude Code para Laravel (backend: la verdad se testea) y Claude Code para Vue (frontend: la verdad se mira). Próximamente en este mismo blog.
Mientras tanto, ¿quieres que revisemos el setup de tu equipo? Hablemos o mira cómo trabajo en servicios.
Fuentes
Documentación oficial (Anthropic)
- Best practices for Claude Code — documentación oficial
- Claude Code Best Practices — Anthropic Engineering
- Memory / CLAUDE.md — cómo Claude recuerda tu proyecto
- The .claude directory — estructura canónica
- Settings — precedencia y ámbitos
- Subagents — contexto aislado y revisión
- MCP — transportes y ámbitos
- Agent Skills — Overview (Claude Docs)
- Repositorio oficial de skills — anthropics/skills
- Cómo los equipos de Anthropic usan Claude Code
Papers, benchmarks y estudios
Artículos relacionados
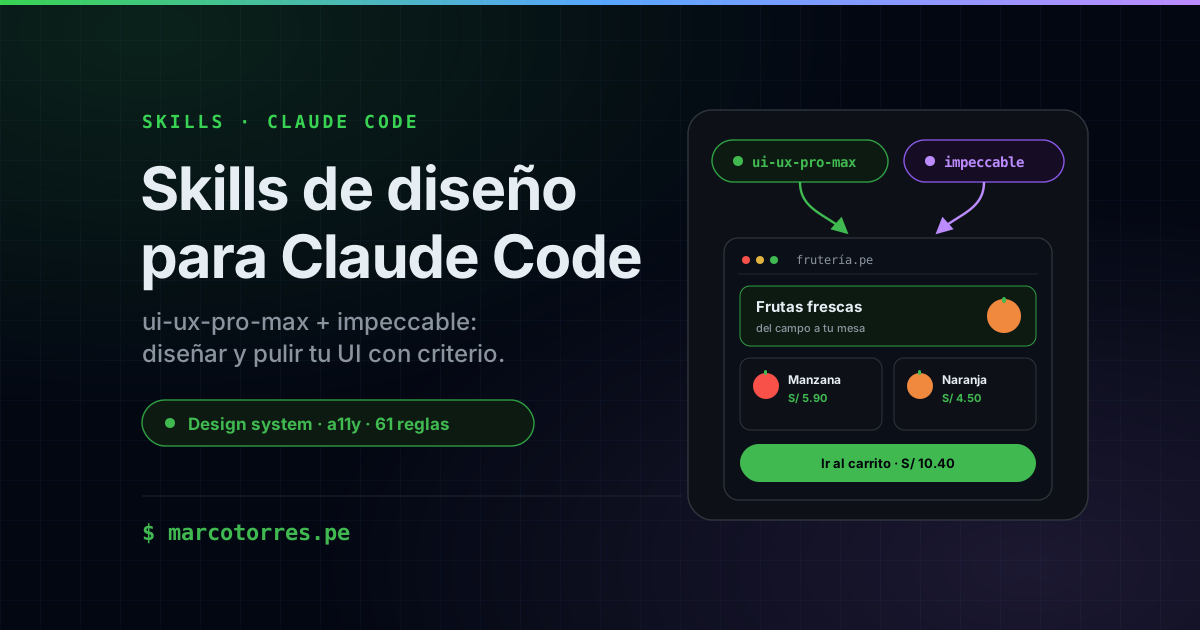
Dos skills para diseñar mejores interfaces con Claude Code: ui-ux-pro-max e impeccable
Claude Code programa muy bien, pero por defecto diseña interfaces del montón —las mismas plantillas SaaS de siempre—. Dos skills de la comunidad lo arreglan por lados distintos: ui-ux-pro-max le da criterio de diseño (design system, paletas, tipografía) e impeccable le da control de calidad (forma, accesibilidad, 61 reglas deterministas). Cómo se instalan, sus comandos y un ejemplo real: montar una frutería online.
¿Código más rápido, deuda más profunda? Lo que dice la ciencia sobre programar con IA
Programar con IA se siente veloz, pero la evidencia de 2026 cuenta otra historia. Un ensayo controlado de METR midió que desarrolladores expertos fueron 19 % más lentos con IA —aunque creían haber ido 20 % más rápido—: esa es la ilusión de velocidad. Y una revisión de 104 fuentes en ACM TOSEM (Faster Code, Deeper Debt?) muestra que la IA no solo amplifica la deuda técnica de siempre (código, diseño, documentación) sino que inventa seis deudas nuevas: gobernanza, integración exprés, de prompts, de datos, ética y de procedencia. Con cifras duras (+41 % de complejidad, +30 % de warnings, la regla del 70/40), el mercado de remediación que Gartner ya anticipa, y —lo importante— la cura, que no es nueva: los tests, el diseño limpio y la revisión que ya conoces. Ejemplos en Laravel 13 y Vue 3, con sustento académico y diagramas.